微共识

遗传检测与冠心病风险评估中国专家共识(2023版)

《遗传检测与冠心病风险评估中国专家共识(2023版)》专家组 中华医学会心血管病学分会预防学组 中华预防医学会心脏病预防与控制专业委员会

请尊重版权,未经授权禁止下载

引用格式: 《遗传检测与冠心病风险评估中国专家共识(2023版)》专家组,中华医学会心血管病学分会预防学组,中华预防医学会心脏病预防与控制专业委员会. 遗传检测与冠心病风险评估中国专家共识(2023版)[J/OL]. 中华心血管病杂志(网络版),2023,6:e1000140(2023‑05‑30). http://www.cvjc.org.cn/index.php/Column/columncon/article_id/320. DOI:10.3760/cma.j.cn116031.2023.1000142.

复制引文
发布日期: 2023/05/30    浏览量: 6750 次

登录后方可查看全文,无账号可以前往注册

版权归中华医学会所有。
未经授权,不得转载、摘编本刊视频资料。
除非特别声明,本刊刊出的所有视频及资料不代表中华医学会和本刊编委会的观点。
目录
视频
遗传检测与冠心病风险评估中国专家共识(2023版)
08:59
音频
遗传检测与冠心病风险评估中国专家共识(2023版)
08:45

引言


随着基因检测技术水平的提高及生物信息学的进展,心血管疾病的遗传检测及风险评估成为可能。临床上,基因检测技术已被用于一些单基因遗传的心血管疾病的诊断及风险评估,如家族性肥厚型心肌病(hypertrophic cardiomyopathy,HCM)、长QT间期综合征和家族性高胆固醇血症(familial hypercholesterolemia,FH)等。遗传检测技术在临床常见的多基因遗传病如冠心病的诊断及风险评估中的作用及价值正在受到广泛的关注。冠心病是一种多因素疾病,是传统危险因素和遗传基因共同作用的结果,并有家族性聚集发病的特点[1‑2]。流行病学研究表明,家族史是冠心病强有力的独立风险因子,也为冠心病的遗传学检测提供了理论基础[3]。因此,采用遗传检测技术评估冠心病风险在临床实践中具有可行性。但在临床实践中,基因检测的应用存在诸多问题,如适应证把握不准确,某些功能有争议的基因也纳入到临床检测范围等。为了进一步提高对基因检测和冠心病发病风险关系的认识,规范冠心病患者进行基因检测及风险评估的流程和方法,《遗传检测与冠心病风险评估中国专家共识(2023版)》专家组联合中华医学会心血管病学分会预防学组及中华预防医学会心脏病预防与控制专业委员会共同制定了本共识,旨在为临床上心血管医生对冠心病的遗传检测及风险评估提供建议。

冠心病遗传风险评估的目的


在心血管领域,遗传检测最早应用于单基因遗传性心血管疾病,如家族性HCM、长QT综合征、FH和马凡综合征等疾病。这些心血管疾病背后的遗传缺陷通常对疾病的发展具有较大的影响,这些遗传缺陷破坏了正常的生物学途径及相关的信号通路,并对最终的疾病临床表型产生显著影响。如HCM的发病和编码肌节蛋白的基因变异有关,与未携带变异基因的HCM患者相比,携带特定变异基因的HCM患者发生心力衰竭或心房颤动的风险可增加2倍[4]。另外,胆固醇升高是冠心病发生发展的重要原因,因此FH患者具有极高的冠心病发病风险。FH的发病机制与LDLR、APOB和PCSK9等基因的变异有关。研究显示,在相同低密度脂蛋白胆固醇(low density lipoprotein cholesterol,LDL‑C)水平,携带上述基因变异的个体发生冠心病的风险增加3倍[5]。因此,针对上述单基因遗传性心血管疾病,基因检测具有重要的临床意义。然而,由于单基因缺陷通常在人群中的发生率很低,因此上述
这些基因检测的方法通常只适用于相对罕见疾病的患者,而对于像冠心病这样的多基因疾病并不适用。但是,冠心病家族聚集发病的临床特点和家族史对冠心病发病的独立影响,提示遗传检测对冠心病的风险评估具有重要价值。因此,越来越多的研究聚焦于遗传检测对冠心病等多基因疾病发病风险的预测价值。

长期以来,因为家族史被证实是冠心病的独立危险因素,人们一直认为冠心病及其危险因素具有显著的遗传成分。例如,在一项对2万多名欧洲人进行的大规模前瞻性队列研究中发现冠心病家族史与冠心病风险显著增加相关,并且这种风险独立于既往已经确定的Framingham风险评分(Framingham risk score,FRS)系统[6]。根据2011—2014年间收集的“美国国家健康和营养调查(National Health and Nutrition Examination Survey,NHANES)”数据,美国约12%的成年人自我报告有明确的冠心病家族史[7]。然而,家族史往往不能提供完整的遗传信息,导致对于家族聚集发病的冠心病个体,是环境因素还是遗传因素起决定作用常常难以区分。另外,尽管目前已经有多个传统的冠心病风险评估模型在临床上应用,但其预测效能依然有待提高[8‑9]。因此,在临床实践中对于冠心病的风险评估加入基因检测数据或许有助于提高对冠心病患者的遗传风险评估能力。

冠心病遗传风险评估面临的挑战


冠心病和其他常见的心血管疾病被认为是“复杂”的遗传性状,常常由数十个甚至数百个遗传变异共同起作用。这些遗传变异与环境因素及生活方式等有显著的交互作用,共同导致冠心病的发生。目前包括中国人群在内的大规模基因组学研究(genome‑wide association analysis,GWAS)已经确定了300余个冠心病易感基因[10‑12],大多数易感基因对冠心病的作用强度[比值比(odds ratio,OR)]值在1.05~1.30之间。如定位于染色体9p21区域的冠心病风险基因位点增加约30%冠心病风险[13]。新近报道的一些和中国人群冠心病相关的基因,如CYP17A1和SElS等基因的遗传变异也可轻度增加冠心病的发病风险[14‑15]。冠心病易感基因的常见变异相对于单基因罕见变异的作用较小,可能与以下原因有关:首先,迄今为止已确定的大多数冠心病风险变异位于基因组的非编码区,或虽位于编码区但仅仅导致蛋白质氨基酸序列的细微变化或基因产物的调节出现干扰,所产生的生物学后果远不如单基因心血管疾病中关键蛋白的典型破坏性缺陷那么明显。例如,染色体9p21上的主要冠心病风险变异位点距离最近的蛋白质编码基因间隔100 000多个碱基,尽管该位点变异所致的功能缺陷仍然是目前深入研究的热点。其次,冠心病是无数失调的生物途径相互作用的最终结果,每一条途径都有许多不同基因产物发挥调节作用。因此,与单基因疾病相反,冠心病可能是由多种非常小的“干扰”组成的“多基因”效应引起的,这些干扰是导致最终临床疾病表型的遗传基础。在这些多基因效应所形成的庞大“网络”中,某些遗传缺陷可能被该网络中的其他遗传缺陷吸收或放大,导致许多复杂的基因微阵列累积,从而促进疾病终末表型的发生。由于这些微阵列非常复杂,需要复杂的数学方法来计算和解释。第三,构成冠心病发病基础的风险等位基因通常通过与环境和行为因素的相互作用而发挥作用。例如,最近发现了13个仅与吸烟人群血脂水平相关的基因位点[16]。这些等位基因与调节血脂水平的生物学关联取决于吸烟量的增加。另外,最近一项大型研究表明,与某些遗传风险评分相关的冠心病风险可能因行为和生活方式不同而显著不同,如体重、吸烟状况、饮食习惯和体力活动水平等[17]。

综上所述,这些发现反映了我们临床上普遍认可的情况:冠心病和其他常见心脏代谢疾病的遗传风险在受累家系中的运行模式并不简单。虽然家族史是冠心病的一个重要风险因素,但它通常不是主要的风险驱动因素,可能被其他临床风险因素(如高血压和吸烟)所“淹没”。因此,如何通过基因检测来提高冠心病的预测能力和风险分层是广大临床心血管医师和学者面临的主要挑战。

冠心病基因检测技术


目前临床上用于冠心病遗传检测的方法有3种:生化遗传检测、基因分型和直接基因测序。

一、生化遗传检测
检测血液或其他组织样本中易于测量的某些蛋白质、代谢物或其他小分子物质的含量或活性水平的变化可以反映遗传基因的变异情况。比如和冠心病发病风险相关的脂蛋白a[lipoprotein‑a,Lp(a)]在大多数实验室都可以检测。个体循环血液中的Lp(a)水平是由遗传决定的,因此直接检测血液循环中Lp(a)的水平可以反映个体遗传的基因型。这些基因型可以为冠心病的风险评估、治疗决策的制定和家系级联筛查提供重要信息。虽然基于生化检测的方法不能提供直接的遗传信息,但这些检测在大多数实验室都可以轻易获得,且价格低廉,结果的解释也相对简单,在临床上有重要的应用价值。另外,随着分子生物学的发展,新兴的转录组学、代谢组学和蛋白质组学技术有望提供更多反映遗传信息且易于测量的生化检测指标,从而丰富个体遗传信息的基因检测“替代物”[18‑22]。

二、基因分型
基因分型技术主要用于检测基因组片段中的特定单核苷酸多态性(single nucleotide polymorphism,SNP)。SNP的选择通常基于其在人群中的突变频率,以及是否与某种疾病风险或相关的表型相关。基因分型的方法有多种,目前常用的基因芯片法(也称为DNA微阵列)可以一次测量数十万个SNP,价格约为数百元人民币。成熟的生物信息学技术能够实现从这些基因型数据中输入数百万个SNP。高通量基因分型技术实现了大规模人群的基因检测,通过对这些遗传信息的分析也反过来促进GWAS和多基因遗传研究的进展,进一步为临床冠心病遗传风险评估提供信息。

三、基因测序
基因测序方法可以确定DNA片段中A、G、C和T核苷酸的线性序列。Sanger测序是所谓的“第一代”DNA测序方法,在临床上常用于评估单个已知基因突变的意义,如突变与疾病发病机制及药物反应性之间的关系或用于家族级联筛查。当某种疾病与多个基因相关时,常采用新型测序技术即所谓的“下一代”测序(next generation sequencing,NGS),该测序方法允许同时对许多小的DNA片段进行并行测序。NGS技术可以实现多个已知基因组合准确、快速、经济的检测。例如,对FH患者基因测序时,通常需要一次性检测多个已知致病基因(LDLR、APOB、PCSK9和LDLRAP1)的单核苷酸变异、DNA片段缺失和重复序列,而NGS技术可以轻松实现这种检测。虽然NGS技术在目前冠心病的临床评估中最常用于FH致病基因的检测,但该技术在其他临床实践和研究应用中开辟了广泛的领域。例如,NGS可以用来进行全外显子组测序(whole exome sequencing,WES)或全基因组测序(whole genome sequencing,WGS),这两种测序方法目前都可用于罕见家族性疾病的诊断[23]。随着WES和WGS成本的降低,以及我们对冠心病遗传因素的进一步理解,WES和WGS可能在冠心病风险评估中发挥越来越大的作用。而针对数百个心血管疾病易感基因的靶向深度测序,不仅可以覆盖常见变异,还可以覆盖罕见变异,体现出明显的价值优势,具有重要的临床应用推广价值。

冠心病单基因遗传风险评估


对于单基因变异所致冠心病的遗传风险评估已经有成熟的方法和策略。对于具有明显遗传模式的冠心病家系进行连锁分析已经确定了可靠的单基因变异[24]。包括导致FH的LDLR、APOB和PCSK9基因的致病性突变体[25‑27],以及高胆固醇血症的常染色体隐性驱动因子,包括LDLRAP1、ABCG5和ABCG8等基因的突变[28‑29]。然而,基于家系的研究所产生的额外效应有限,类似研究中提出的冠心病的其他单基因变异,如ALOX5AP[30]和MEF2A[31]基因的变异所致冠心病的结果在后续的研究中尚未得到证实。


一、针对FH的基因检测
FH是一种胆固醇代谢障碍的遗传性疾病,循环血液中LDL‑C水平终身升高,导致早发冠心病。临床表型取决于特定致病性变异和遗传等位基因的数量。杂合子FH相对较常见,发病率约为1/220,是LDLR、APOB或PCSK9基因中致病性变异的常染色体显性遗传的结果。纯合子FH罕见,患病率为1/30万~1/20万,可以导致更严重的临床表型。另外,低密度脂蛋白受体衔接蛋白(low density lipoprotein receptor adaptor protein 1,LDLRAP1)基因的纯合突变所致的FH,也可以常染色体隐性方式遗传。迄今为止,已鉴定出1 700多种LDLR突变体,可以导致85%~90%的FH病例。有5%~15%的FH患者可以检出APOB基因的致病性变异,频率要比LDLR突变所致FH低得多,而PCSK9或LDLRAP1的突变仅在不到1%的病例中可以检测到。

FH的诊断主要基于其临床诊断标准,包括血脂水平、个人病史、家族史和体检结果,但大多数FH患者未被诊断和治疗不足。随着基因检测的最新进展,目前临床上已经开展对已知与FH相关的遗传变异进行检测和鉴定。2018年,美国心脏病学会(American College of Cardiology,ACC)制定的FH基因检测指南建议,根据临床标准,疑似或确诊FH的患者应进行基因检测,包括检测LDLR、APOB和PCSK9基因。对于疑似患者还应该检测不太常见的致病性突变,包括LDLRAP1、LIPA、ABCG5、ABCG8和APOE等基因。通过基因检测的结果,可以明确患者的致病因素,通过合理的治疗,改善患者的临床结局。FH患者在LDL‑C水平相同的情况下,与未发生突变的个体相比,发生突变的个体患冠心病的风险增加3倍[5]。因此对于携带突变基因的FH患者应该给予更积极的降脂治疗。还有证据表明,接受基因检测的患者对更强的他汀类药物治疗依从性较高,从而使患病个体的LDL‑C水平降低幅度更大[32]。另外,对所携带致病性突变类型的了解也可以指导治疗决策。例如,对于携带两个LDLR基因Null突变的FH患者,PCSK9抑制剂治疗无效,但对功能获得性PCSK9突变的患者有重要价值[33]。基因检测也有助于早期识别FH儿童,这可能对患儿临床结局产生深远影响。最近发表的一项前瞻性队列研究表明,200多名在儿童时期开始接受他汀类药物治疗的FH患者,与其父母在成年后才开始他汀类药物治疗相比,在20年内心血管事件和心血管相关死亡的发生率显著降低[34]。


二、CYP2C19基因检测
冠心病患者冠状动脉支架置入术后双联抗血小板治疗是临床实践中标准的治疗方案,但氯吡格雷的抗血小板疗效在不同的人群中具有明显的差异。其主要原因是CYP2C19基因多态性所致。最重要的是CYP2C19功能缺失型(*2或*3)多态性,它可以导致CYP2C19酶活性的丧失。当CYP2C19野生型(*1)等位基因被*2或者*3取代时,氯吡格雷在肝脏中无法转化为具有抗血小板活性的代谢产物。另外还有一种CYP2C19功能增强型等位基因突变体(*17),这导致CYP2C19酶活性增加。现有证据表明,*2和*3在国人中发生频率较高,前者占40%~50%,后者占5%~10%。诸多证据显示CYP2C19*2和*3等位基因携带者发生缺血事件的风险明显增加。但是CYP2C19*17对冠心病经皮冠状动脉介入治疗术后出血或缺血性事件的影响目前结论尚不一致。因此目前临床检测的CYP2C19主要涉及*2和*3等位基因。Xie等是最早基于CYP2C19基因型指导急性冠状动脉综合征(acute coronary syndrome,ACS)患者个体化抗血小板治疗的团队[35‑36]。后续的随机对照临床试验也表明根据CYP2C19基因型指导的个体化抗血小板治疗使患者获益。但目前比较一致的建议是CYP2C19基因分型不应在稳定性冠心病患者中常规使用,但在特定的高风险临床情况下,如左主干支架置入术、复杂病变、双支分叉病变介入治疗和支架血栓形成史等,可以合理考虑进行CYP2C19基因型检测。


三、临床Lp(a)水平检测
Lp(a)是含载脂蛋白B(apolipoprotein B,apoB)‑100的脂蛋白家族的一员,所有这些脂蛋白都与冠心病的风险增加有关。Lp(a)与其他apoB,如低密度脂蛋白(low density lipoprotein,LDL)的区别在于存在载脂蛋白(a),这是一种通过二硫键与apoB共价结合的糖蛋白。LPA等位基因以共显性方式表达,导致70%~90%的Lp(a)血液水平的变异[37]。通过流行病学调查、GWAS及孟德尔随机研究等方法,Lp(a)基因变异被确定为动脉粥样硬化性心血管疾病的致病风险因素。据估计,全球有20%~30%的人口Lp(a)水平升高且处于致动脉粥样硬化的范围。虽然Lp(a)导致动脉粥样硬化的机制和其他含有apoB的脂蛋白类似,但Lp(a)可能通过增加氧化磷脂含量、增强和内皮细胞的结合,以及促进单核细胞转运来进一步加剧动脉粥样硬化的发展。根据ACC/美国心脏协会(American Heart Association,AHA)指南建议,在具有冠心病临界或者中等风险的成年人中,Lp(a)升高是冠心病风险的增强因素,因此,在对该类人群决定启动他汀类药物治疗进行一级预防时应该考虑该因素[38]。根据美国国家脂质协会(National Lipid Association,NLA)指南的推荐,在冠心病二级预防应用他汀类药物联合依折麦布或者前蛋白转化酶枯草杆菌蛋白酶/kexin 9型(proprotein convertase subtilisin/kexin type 9,PCSK9)抑制剂强化降脂治疗中,应该进一步考虑Lp(a)的影响[39]。该指南中的建议主要基于FOURIER试验和ODYSSEY OUTCOMES试验的结果。这2项临床试验表明,对于冠心病合并Lp(a)升高的患者,加用PCSK9抑制剂获益最大。当前ACC/AHA指南不建议常规进行Lp(a)检测,但对于早发冠心病患者或者具有早发冠心病家族史,仅用传统危险因素难以解释的患者建议进行Lp(a)检测[38]。欧洲心脏病学会/欧洲动脉粥样硬化学会(European Society of Cardiology/European Atherosclerosis Society,ESC/EAS)指南也提出了类似的建议。但在2019年更新的指南中建议在所有的成年人群中均应该检测一次Lp(a)水平(证据水平ⅡB)[37]。目前针对Lp(a)的靶向治疗备受关注,同时也取得了长足的发展。随着冠心病遗传风险评估工具被纳入临床实践并指导治疗决策逐渐被接受和认可,Lp(a)的生化检测很可能成为临床冠心病遗传风险评估工具包中越来越重要的组成部分。

冠心病多基因风险评估


一、冠心病多基因风险评估方法
冠心病是一种多基因疾病,目前GWAS研究已经确定了300余个冠心病易感位点。评估冠心病的发病风险采用多基因风险评分(polygenic risk score,PRS),也称为遗传或基因组风险评分,是根据通过GWAS识别的几十到数千个甚至是数百万个变异位点联合评估个体的患病风险。PRS模型的开发有多种方法,不同的模型在包含的遗传位点数量、统计设计和普遍适用性有所不同。一般来说,PRS是基于GWAS估计的致病效应大小的个人风险等位基因总数加权所得。目前,除了冠心病,PRS已被开发用于预测许多其他疾病,包括2型糖尿病、阿尔茨海默病、前列腺癌、乳腺癌和精神分裂症等。对于冠心病最早的PRS模型于2010年开发,由13个与心肌梗死和冠心病相关的SNP组成,包括9p21、PSCK9、MIA3和LDLR等基因和位点[41]。该风险评分应用于来自前瞻性队列研究的30 725名瑞典和芬兰参与者,证实了位于最高的遗传风险五分位数的个体在随访大约10年期间冠心病发病风险增加70%[41]。同期还有其他冠心病PRS模型开发采用了类似的方法,包括大约50个SNP。在2015至2016年间发表的几项研究中,研究人员通过使用更宽松的SNP纳入阈值和使用更先进的技术并考虑到连锁不平衡的影响开发了改良的PRS模型,提高了风险预测的效能[41]。新近研究开发了包括49 000个来自冠心病GWAS荟萃分析获得的SNPs,发现最高五分位人群的冠心病累积风险比最低五分位人群增加3.2倍[42]。有两个由英美国家团队学者开发的PRS模型分别由170万和660万个变异位点组成,并在英国生物银行(UK Biobank)队列中进行了检测和验证。英国生物银行是2006年启动的一项基于人群的队列研究,提供了约500 000名年龄在40~69岁的个体的综合健康数据(包括基因分型)。这项包括170万变异位点的PRS模型被称为“metaGRS”,由Inouye等[43]开发,综合了3个不同PRS模型进行了加权汇总所得。其中包括前述的涵盖49 000个SNP的PRS模型以及来自CARDioGRAMplusC4D联合体开发的2个PRS模型。MetaGRS模型验证结果显示,位于最高五分位的个体的冠心病风险比最低五分位的个体高4倍。MetaGRS的预测能力和基于6个常规风险因素的模型具有相似的C统计量,表明预测能力相当。另一项涵盖660万个SNP的PRS模型由Khera等[44]使用先进的计算方法所构建,被称为“GRSCAD”。对英国生物银行近300 000名参与者进行了GRSCAD检测,发现8%的个体冠心病的发生风险增加约3倍。2022年5月,顾东风教授团队通过整合冠心病及主要危险因素的540个基因信息,构建了适用于中国人群和东亚人群的冠心病metaPRS,该PRS可以有效预测冠心病发病风险,描绘个体随年龄增长的发病轨迹。此外,此PRS模型可以显著提升常规临床风险的精准预测和精细分层能力,可以早期识别冠心病高风险个体,为冠心病的高危人群筛查和精准预防提供重要科学证据[45]。


二、多基因风险评分的临床应用
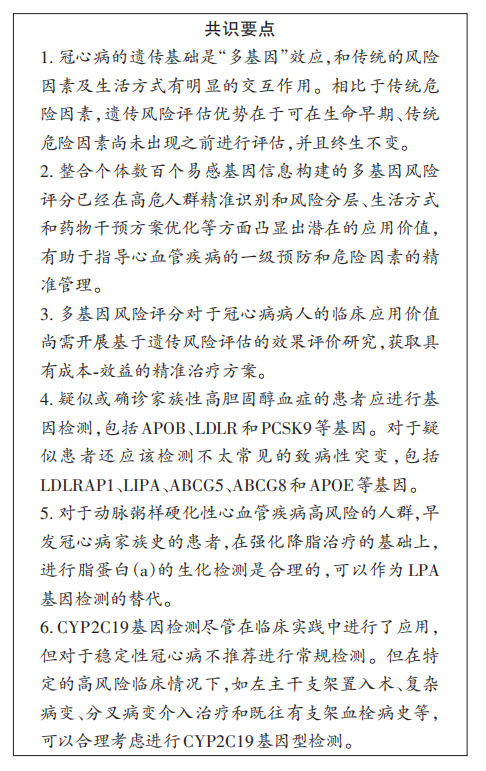
相比于传统危险因素,遗传风险评估优势在于可在生命早期、传统危险因素尚未出现之前进行评估,并且终生不变。目前多基因遗传评分已经在心血管疾病高危人群精准识别和风险分层、生活方式和药物干预方案优化等方面凸显出潜在的应用价值,有助于指导心血管疾病的一级预防和危险因素的精准管理。自从第一个PRS系统开发以来,心血管病学家一直努力采用PRS对现有冠心病的风险评估模型进行优化和改进。例如,当对一个包含多达50个SNP的冠心病PRS添加到FRS中时,可以改善其对散发冠心病的发病风险的预测效能[46]。另一项大型欧洲队列研究表明,当在传统的风险评分FRS或汇总队列方程(pooled cohort equations,PCEs)中增加包括49 000个SNP的PRS积分时,对冠心病10年发病风险的预测能力明显提高,包括C统计量和净再分类指数(net reclassification imporvement, NRI)均有所改善[47]。Mosley等[48]将GRSCAD评分系统应用于两项大型人群队列研究并证明其与散发冠心病发病风险相关,但将其添加到PCEs评分系统后,C统计量或NRI无明显改善。Elliott等[49]将包含超过100万个SNP的风险评分应用于英国生物银行队列,以评估加入PCEs后风险预测效能是否得到改善。结果显示将PRS添加到PCEs后,尽管发现了统计学上的差异,但改善的临床意义有限(C统计量仅增加0.02)。这些PRS评分系统对没有冠心病危险因素的年轻人应用价值比较大,通过PRS评分系统识别高危人群,早期进行生活方式或者进行药物干预,可能会使这部分人群从中早期获益。

为了使PRS在不同人群中得以广泛的临床应用,需要开发和验证特定种族的PRS。基于欧美人群开发的PRS评分对非欧洲裔人群的风险预测能力较低[50]。主要原因可能是这些用于构建PRS的基因位点多来源于欧裔人群,缺乏种族多样性。因此国际同行正致力于研发创新性算法以利用欧美人群大规模基因组数据构建跨种族人群的遗传风险评分模型[51]。为了构建针对东亚人群特异的多基因风险评估模型,我国学者近期通过整合中国、日本、韩国、新加坡等国家的26万东亚人群基因组数据构建了冠心病、卒中和血脂异常PRS,并在我国随访20年的4万多人群队列中揭示了遗传风险在指导生活方式精准干预及高危人群筛查中的重要应用价值。首先可以单独开展遗传风险评估指导,及早开展生活方式管理。通过评价不同遗传风险人群保持理想的心血管健康指标的获益,发现改善生活方式可缓解甚至逆转先天高遗传背景带来的风险,而且冠心病高遗传风险人群从中获得的绝对风险降幅最大,提供了因人而异的一级预防生活方式干预新证据[52]。同时发现多基因遗传风险评分的高低决定着个体血脂(包括总胆固醇、HDL‑C、LDL‑C和甘油三酯)年均变化特征,低遗传风险者血脂年均变化呈现负增长或者不增长,而高遗传风险者的血脂年均增长幅度显著加大,揭示了遗传因素在预测个体生命周期血脂变化轨迹及血脂精准管理中的临床价值[53]。多项国外研究也体现出遗传风险指导生活方式的应用价值。如来自3个前瞻性队列的约50 000例患者的研究发现,遗传风险得分最高组的患者冠心病风险最大,而健康的生活方式可以使该组冠心病的相对风险下降50%[17]。Inouye等[43]也证明了生活方式可以显著降低高遗传背景人群的发病风险。

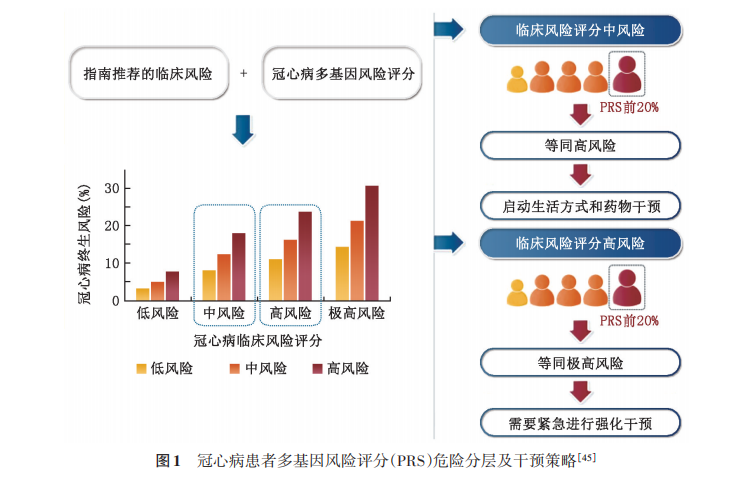
其次,遗传风险评分可以作为一个增强预测因子与常规临床风险联合指导高危人群筛查和精准管理。如结合现行《中国心血管病风险评估和管理指南》[54],PRS尤其是对于常规中、高临床风险人群临床决策的制订具有重要的指导意义(图1)[45]。现行指南对常规中等临床风险人群缺乏明确的干预建议,但如果合并高遗传风险,则建议启动生活方式和药物干预。对于高临床风险个体,如果同时伴有高遗传风险,则需要尽快强化生活方式干预和药物治疗。为了便于指导冠心病临床防治实践,研究人员还制订了不同性别和年龄组人群的可视化风险评估量表图。美国随机临床试验研究也评估了多基因风险结合常规临床风险指导高危人群的管理实践,研究发现与单纯告知冠心病临床风险组相比,同时告知临床风险和遗传风险组个体他汀药物服药率和血脂达标率显著提升,体现了遗传风险在指导高危人群管理效果和提升依从性中的重要价值[55]。针对我国当前高血压、高脂血症的管理率、治疗率和控制率较低的现状,更加凸显了开展遗传风险个体化评估的价值。

另外,遗传风险评分可以用于指导高危人群的精准药物管理。基于欧洲人群的队列研究和随机对照研究中评估了不同冠心病遗传风险人群服用降脂药物对减少心血管疾病发生的获益。研究发现无论服用他汀药物还是PCSK9单克隆抗体,高遗传风险的人群冠心病风险降低幅度最大,而低遗传风险人群降脂药物的获益甚至没有达到显著,体现了遗传风险在血脂管理和优化用药方案中的重要价值[56‑57]。


三、基因检测对未来临床实践的影响
冠心病PRS在指导高危人群筛查、生活方式和药物精准防治等干预决策中体现出了临床应用价值。然而目前针对不同遗传风险人群生活方式和药物干预获益的证据主要来自于队列人群研究,还需要开展基于遗传风险的随机化临床试验和人群干预研究,真实评价治疗和干预效果,并开展获益的卫生经济学评价,形成基于不同遗传风险分层的个体化干预方案,最终实现推广应用。同时PRS对冠心病患者的长期预后判断及长期药物干预等方面的指导价值仍需进一步研究。

目前健康产业领域基因检测逐渐成为一项可选的体检项目,包括有资质的医疗机构自建的基因分析平台及一些直接面向消费者的商业基因检测公司。尽管基因组遗传信息检测技术和成本已适合推广普及,但能有效解读个体遗传信息的预测模型却极其匮乏。利用心脑血管疾病多基因遗传风险评分技术可以指导企业研发中国人群心脑血管疾病PRS试剂盒和智能分析与遗传咨询平台,实现对遗传信息准确解读进而给予个性化的干预建议。而针对病人的评估和建议有必要在心脏病学部门内的专业心血管遗传学实验室进行,这些实验室通常应拥有心脏病学专家。这种模式有利于心脏病学专家有效地将基因检测结果与其他关键临床数据(如病史、体检结果、心血管影像和功能结果)相结合,同时为患者提供遗传咨询,这对于理解遗传检测的意义和结果至关重要。所有这些信息,包括基因检测,都可以被全面评估,以帮助指导治疗决策的制定和家庭级联检测的动员和协调。AHA最近发表了一份科学声明,呼吁更广泛地建立专门的临床心血管遗传学计划(CVGPs)[58]。该声明提供了在机构内创建CVGPs的详细实践经验和策略,阐述了对心血管遗传学专门培训和研究项目的日益增长的需求,甚至引入了“遗传心脏病学专家”的“新兴亚专业”理念。

小结


目前冠心病遗传风险的评估策略主要依赖于对某些单基因心血管疾病遗传检测的成功经验。由传统危险因素构建的冠心病风险预测模型在临床应用中发挥了积极作用,多基因风险评估模型的开发和应用引起了临床医生和心血管病学专家和研究者极大的兴趣,尤其是高危人群风险预测和分层、筛查方案优化、生活方式和药物精准干预等方面引起了广大心血管研究领域广泛的关注。尽管有些相关问题仍然有待解决或回答,但多基因风险评估模型已为冠心病发病风险的评估提供了新型工具和更多的选择。
  • 作者: 《遗传检测与冠心病风险评估中国专家共识(2023版)》专家组    中华医学会心血管病学分会预防学组    中华预防医学会心脏病预防与控制专业委员会   

  • 作者单位:   

  • 通信作者: 马依彤,新疆医科大学第一附属医院心脏中心,Email: myt‑xj@163.com,顾东风,中国医学科学院阜外医院流行病学部 南方科技大学医学院,Email: gudongfeng@cashq.ac.cn

  • 关键词: 基因检测;冠心病;风险评估与减低

  • DOI: 10.3760/cma.j.cn116031.2023.1000142

  • 基金项目: 无

  • 利益冲突: 无

  • 收稿日期: 2023-01-16

  • 录用日期: 2023-04-19

  • 本文编辑: 史红

  • 摘要中文

    无

    摘要英文

    无


    本研究主要材料与器材

    无

    参考文献

    [1] Dai CF, Xie X, Yang YN, et al. Relationship between CYP17A1 genetic polymorphism and coronary artery disease in a Chinese Han population[J]. Lipids Health Dis, 2015,14:16. DOI: 10.1186/s12944‑015‑0007‑4.
    [2] Nikpay M, Goel A, Won HH, et al. A comprehensive 1,000 Genomes‑based genome‑wide association meta‑analysis of coronary artery disease[J]. Nat Genet, 2015,47(10):1121‑1130. DOI: 10.1038/ng.3396.
    [3] Wahrenberg A, Magnusson PK, Discacciati A, et al. Family history of coronary artery disease is associated with acute coronary syndrome in 28,188 chest pain patients[J]. Eur Heart J Acute Cardiovasc Care, 2020,9(7):741‑747. DOI: 10.1177/2048872619853521.
    [4] Ho CY, Day SM, Ashley EA, et al. Genotype and lifetime burden of disease in hypertrophic cardiomyopathy: insights from the sarcomeric human cardiomyopathy registry (SHaRe)[J]. Circulation, 2018,138(14):1387‑1398. DOI: 10.1161/CIRCULATIONAHA.117.033200.
    [5] Khera AV, Won HH, Peloso GM, et al. Diagnostic yield and clinical utility of sequencing familial hypercholesterolemia genes in patients with severe hypercholesterolemia[J]. J Am Coll Cardiol, 2016,67(22):2578‑2589. DOI: 10.1016/j.jacc.2016.03.520.
    [6] Sivapalaratnam S, Boekholdt SM, Trip MD, et al. Family history of premature coronary heart disease and risk prediction in the EPIC‑Norfolk prospective population study[J]. Heart, 2010,96(24):1985‑1989. DOI: 10.1136/hrt.2010.210740.
    [7] Benjamin EJ, Blaha MJ, Chiuve SE, et al. Heart disease and stroke statistics‑2017 update: a report from the American Heart Association[j]. Circulation,2017,135(10):e146‑e603. DOI: 10.1161/CIR.0000000000000485.
    [8] Zheng YY, Wu TT, Gao Y, et al. A novel ABC score predicts mortality in non‑st‑segment elevation acute coronary syndrome patients who underwent percutaneous coronary intervention[J]. Thromb Haemost, 2021,121(3):297‑308. DOI: 10.1055/s‑0040‑1718411.
    [9] Zheng YY, Wu TT, Liu ZQ, et al. Gut microbiome‑based diagnostic model to predict coronary artery disease[J]. J Agric Food Chem, 2020,68(11):3548‑3557. DOI: 10.1021/acs.jafc.0c00225.
    [10] Lu X, Peloso GM, Liu DJ, et al. Exome chip meta‑analysis identifies novel loci and East Asian‑specific coding variants that contribute to lipid levels and coronary artery disease[J]. Nat Genet, 2017, 49(12):1722‑1730. DOI: 10.1038/ng3978.
    [11] Lu X, Wang L, Chen S, et al. Genome‑wide association study in Han Chinese identifies four new susceptibility loci for coronary artery disease[J]. Nat Genet,2012,44(8):890‑894. DOI: 10.1038/ng.2337.
    [12] Chen Z, Schunkert H. Genetics of coronary artery disease in the post‑GWAS era[J]. J Intern Med,2021,290(5):980‑992. DOI: 10.1111/joim.13362.
    [13] Samani NJ, Erdmann J, Hall AS, et al. Genomewide association analysis of coronary artery disease[J]. N Engl J Med, 2007,357(5):443‑453. DOI: 10.1056/NEJMoa072366.
    [14] Dai CF, Xie X, Ma YT, et al. Haplotype analyses of CYP17A1 genetic polymorphisms and coronary artery disease in a Uygur population[J]. J Renin Angiotensin Aldosterone Syst,2015 ,16(2):389-398. DOI: 10.1177/1470320314565840.
    [15] Wang DY, Wu TT, Zheng YY, et al. Nomogram developed with selenoprotein S (SelS) genetic variation and clinical characteristics predicting risk of coronary artery disease in a Chinese population[J]. Cardiovasc Diagn Ther, 2020,10(4):770‑777. DOI: 10.21037/cdt‑20‑296.
    [16] Bentley AR, Sung YJ, Brown MR, et al. Multi‑ancestry genome‑wide gene‑smoking interaction study of 387,272 individuals identifies new loci associated with serum lipids[J]. Nat Genet, 2019,51(4):636‑648. DOI: 10.1038/s41588‑019‑0378‑y.
    [17] Khera AV, Emdin CA, Drake I, et al. Genetic risk, adherence to a healthy lifestyle, and coronary disease[J]. N Engl J Med,2016,375(24):2349‑2358. DOI: 10.1056/NEJMoa1605086..
    [18] Rhee EP, Ho JE, Chen MH, et al. A genome‑wide association study of the human metabolome in a community‑based cohort[J]. Cell Metab, 2013,18(1):130‑143. DOI: 10.1016/j.cmet.2013.06.013.
    [19] Rhee EP, Yang Q, Yu B, et al. An exome array study of the plasma metabolome[J]. Nat Commun, 2016,7:12360. DOI: 10.1038/ncomms12360.
    [20] Benson MD, Yang Q, Ngo D, et al. Genetic architecture of the cardiovascular risk proteome[J]. Circulation, 2018,137(11):1158‑1172. DOI: 10.1161/CIRCULATIONAHA. 117.029536.
    [21] Emilsson V, Ilkov M, Lamb JR, et al. Co‑regulatory networks of human serum proteins link genetics to disease[J]. Science, 2018,361(6404):769‑773. DOI: 10.1126/science.aaq1327.
    [22] Tandy‑Connor S, Guiltinan J, Krempely K, et al False‑positive results released by direct‑to‑consumer genetic tests highlight the importance of clinical confirmation testing for appropriate patient care[J]. Genet Med,2018,20(12):1515‑1521. DOI: 10.1038/gim.2018.38.
    [23] Krier JB, Kalia SS, Green RC. Genomic sequencing in clinical practice: applications, challenges, and opportunities[J]. Dialogues Clin Neurosci, 2016,18(3):299‑312. DOI: 10.31887/DCNS.2016.18.3/jkrier.
    [24] Khera AV, Kathiresan S. Genetics of coronary artery disease: discovery, biology and clinical translation[J]. Nat Rev Genet, 2017,18(6):331‑344. DOI: 10.1038/nrg.2016.160.
    [25] Lehrman MA, Schneider WJ, Südhof TC, et al. Mutation in LDL receptor: Alu‑Alu recombination deletes exons encoding transmembrane and cytoplasmic domains[J]. Science, 1985,227(4683):140‑146. DOI: 10.1126/science.3155573.
    [26] Soria LF, Ludwig EH, Clarke HR, et al. Association between a specific apolipoprotein B mutation and familial defective apolipoprotein B‑100[J]. Proc Natl Acad Sci USA, 1989,86(2):587‑591. DOI: 10.1073/pnas.86.2.587.
    [27] Abifadel M, Varret M, Rabès JP, et al. Mutations in PCSK9 cause autosomal dominant hypercholesterolemia[J]. Nat Genet, 2003,34(2):154‑156. DOI: 10.1038/ng1161.
    [28] Garcia CK, Wilund K, Arca M, et al. Autosomal recessive hypercholesterolemia caused by mutations in a putative LDL receptor adaptor protein[J]. Science, 2001,292(5520):1394‑1398. DOI: 10.1126/science.1060458.
    [29] Berge KE, Tian H, Graf GA, et al. Accumulation of dietary cholesterol in sitosterolemia caused by mutations in adjacent ABC transporters[J]. Science, 2000,290(5497):1771‑1775. DOI: 10.1126/science.290.5497.1771.
    [30] Helgadottir A, Manolescu A, Thorleifsson G, et al. The gene encoding 5‑lipoxygenase activating protein confers risk of myocardial infarction and stroke[J]. Nat Genet, 2004,36(3):233‑239. DOI: 10.1038/ng1311.
    [31] Wang L, Fan C, Topol SE, et al. Mutation of MEF2A in an inherited disorder with features of coronary artery disease[J]. Science, 2003,302(5650):1578‑1581. DOI: 10.1126/science.1088477.
    [32] Sturm AC, Knowles JW, Gidding SS, et al. Clinical genetic testing for familial hypercholesterolemia: JACC scientific expert panel[J]. J Am Coll Cardiol,2018,72(6):662‑680. DOI: 10.1016/j.jacc.2018.05.044.
    [33] Hopkins PN, Defesche J, Fouchier SW, et al. Characterization of autosomal dominant hypercholesterolemia caused by PCSK9 gain of function mutations and its specific treatment with alirocumab, a PCSK9 monoclonal antibody[J]. Circ Cardiovasc Genet, 2015,8(6):823‑831. DOI: 10.1161/CIRCGENETICS.115.001129.
    [34] Luirink IK, Wiegman A, Kusters DM, et al. 20‑year follow‑up of statins in children with familial hypercholesterolemia[J]. N Engl J Med,2019,381(16):1547‑1556. DOI: 10.1056/NEJMoa1816454.
    [35] Xie X, Ma YT, Yang YN, et al. Personalized antiplatelet therapy according to CYP2C19 genotype after percutaneous coronary intervention: a randomized control trial[J]. Int J Cardiol, 2013,168(4):3736‑3740. DOI: 10.1016/j.ijcard.2013.06.014.
    [36] Fox CS, Hall JL, Arnett DK, et al. Future translational applications from the contemporary genomics era: a scientific statement from the American Heart Association[J]. Circulation,2015,12,131(19):1715‑1736. DOI: 10.1161/CIR.0000000000000211.
    [37] Kronenberg F, Utermann G. Lipoprotein(a): resurrected by genetics[J]. J Intern Med,2013,273(1):6‑30. DOI: 10.1111/j.1365‑2796.2012.02592.x.
    [38] Grundy SM, Stone NJ, Bailey AL, et al. 2018 AHA/ACC/AACVPR/AAPA/ABC/ACPM/ADA/AGS/APhA/ASPC/NLA/PCNA guideline on the management of blood cholesterol: a report of the American College of Cardiology/American Heart Association Task Force on clinical practice guidelines[J]. J Am Coll Cardiol, 2019,73(24):e285‑e350. DOI: 10.1016/j.jacc.2018.11.003.
    [39] Wilson DP, Jacobson TA, Jones PH, et al. Use of lipoprotein(a) in clinical practice: a biomarker whose time has come. A scientific statement from the National Lipid Association[J]. J Clin Lipidol, 2022,16(5):e77‑e95. DOI: 10.1016/j.jacl.2022.08.007.
    [40] Mach F, Baigent C, Catapano AL, et al. 2019 ESC/EAS Guidelines for the management of dyslipidaemias: lipid modification to reduce cardiovascular risk[J]. Eur Heart J,2020,41(1):111‑188. DOI: 10.1093/eurheartj/ehz455.
    [41] Assimes TL, Salfati EL, Del Gobbo LC. Leveraging information from genetic risk scores of coronary atherosclerosis[J]. Curr Opin Lipidol, 2017,28(2):104‑112. DOI: 10.1097/MOL.0000000000000400.
    [42] Abraham G, Havulinna AS, Bhalala OG, et al. Genomic prediction of coronary heart disease[J]. Eur Heart J, 2016,37(43):3267‑3278. DOI: 10.1093/eurheartj/ehw450.
    [43] Inouye M, Abraham G, Nelson CP, et al. Genomic risk prediction of coronary artery disease in 480,000 adults: implications for primary prevention[J]. J Am Coll Cardiol, 2018,72(16):1883‑1893. DOI: 10.1016/j.jacc.2018.07.079.
    [44] Khera AV, Chaffin M, Aragam KG, et al. Genome‑wide polygenic scores for common diseases identify individuals with risk equivalent to monogenic mutations[J]. Nat Genet, 2018,50(9):1219‑1224. DOI: 10.1038/s41588‑018‑0183‑z.
    [45] Lu X, Liu Z, Cui Q, et al. A polygenic risk score improves risk stratification of coronary artery disease: a large‑scale prospective Chinese cohort study[J]. Eur Heart J,2022,43(18):1702‑1711. DOI: 10.1093/eurheartj/ehac093.
    [46] Iribarren C, Lu M, Jorgenson E, et al. Clinical utility of multimarker genetic risk scores for prediction of incident coronary heart disease: a cohort study among over 51 000 individuals of European ancestry[J]. Circ Cardiovasc Genet, 2016,9(6):531‑540. DOI: 10.1161/CIRCGENETICS.116.001522.
    [47] Wünnemann F, Sin Lo K, Langford‑Avelar A, et al. Validation of genome‑wide polygenic risk scores for coronary artery disease in french canadians[J]. Circ Genom Precis Med, 2019,12(6):e002481. DOI: 10.1161/CIRCGEN.119.002481.
    [48] Mosley JD, Gupta DK, Tan J, et al. Predictive accuracy of a polygenic risk score compared with a clinical risk score for incident coronary heart disease[J]. JAMA, 2020,323(7):627‑635. DOI: 10.1001/jama.2019.21782.
    [49] Elliott J, Bodinier B, Bond TA, et al. Predictive accuracy of a polygenic risk score‑enhanced prediction model vs a clinical risk score for coronary artery disease[J]. JAMA, 2020,323(7):636‑645. DOI: 10.1001/jama.2019.22241.
    [50] Duncan L, Shen H, Gelaye B, et al. Analysis of polygenic risk score usage and performance in diverse human populations[J]. Nat Commun, 2019,10(1):3328. DOI: 10.1038/s41467‑019‑11112‑0.
    [51] Wang M, Menon R, Mishra S, et al. Validation of a genome‑wide polygenic score for coronary artery disease in South Asians[J]. J Am Coll Cardiol, 2020,76(6):703‑714. DOI: 10.1016/j.jacc.2020.06.024.
    [52] Cui Q, Liu Z, Li J, et al. Impact of cardiovascular health and genetic risk on coronary artery disease in Chinese adults[J]. Heart,2023,109(10):756‑762. DOI: 10.1136/heartjnl‑2022‑321657.
    [53] Li J, Liu M, Liu F, et al. Age and genetic risk score and rates of blood lipid changes in China[J]. JAMA Netw Open,2023,6(3):e235565. DOI: 10.1001/jamanetworkopen.2023.5565.
    [54] 中国心血管病风险评估和管理指南编写联合委员会. 中国心血管病风险评估和管理指南[J]. 中华预防医学杂志, 2019, 53(1): 13-35. DOI: 10.3760/cma.j.issn.0253-9624.2019.01.004.
    [55] Kullo IJ, Jouni H, Austin EE, et al. Incorporating a genetic risk score into coronary heart disease risk estimates: effect on low‑density lipoprotein cholesterol levels (the MI‑GENES Clinical Trial)[J]. Circulation,2016,133(12):1181‑1188. DOI: 10.1161/CIRCULATIONAHA.115.020109.
    [56] Marston NA, Kamanu FK, Nordio F, et al. Predicting benefit from evolocumab therapy in patients with atherosclerotic disease using a genetic risk score: results from the FOURIER Trial[J]. Circulation,2020,141(8):616‑623. DOI: 10.1161/CIRCULATIONAHA.119.043805.
    [57] Mega JL, Stitziel NO, Smith JG, et al. Genetic risk, coronary heart disease events, and the clinical benefit of statin therapy: an analysis of primary and secondary prevention trials[J]. Lancet, 2015,385(9984):2264‑2271. DOI: 10.1016/S0140‑6736(14)61730‑X.
    [58] Ahmad F, McNally EM, Ackerman MJ, et al. Establishment of specialized clinical cardiovascular genetics programs: recognizing the need and meeting standards: a scientific statement from the American Heart Association[J]. Circ Genom Precis Med,2019,12(6):e000054.DOI: 10.1161/HCG.0000000000000054.
    无
    发表评论文明上网理性发言,请遵守互动礼仪
    您需要先 登录 后方可发表评论。
    • 全部评论
    • /
    • 我的评论
    • 最新
    • /
    • 最热